Intel เร่งพัฒนาโครงสร้างพื้นฐานด้าน AI รับยุค Agentic AI เปิดรายละเอียด GPU D-Series หน่วยความจำสูงสุด 480GB
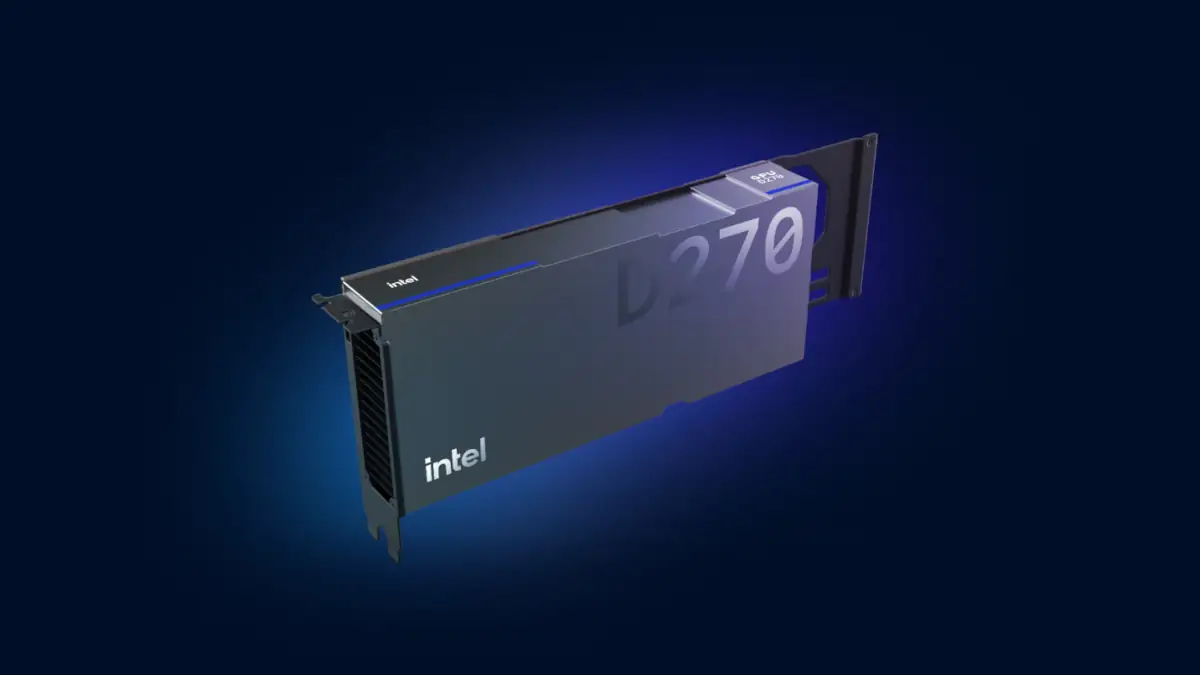
Intel เดินหน้าพัฒนาโครงสร้างพื้นฐาน AI แบบเปิด (Open AI Infrastructure) เพื่อรองรับการเติบโตของ Agentic AI โดยเปิดเผยรายละเอียดเพิ่มเติมของ Intel GPU D-Series ซึ่งมีชื่อรหัสเดิมว่า Crescent Island พร้อมนำเสนอสถาปัตยกรรมระบบเซิร์ฟเวอร์ที่ใช้ Intel Xeon และแนวทางพัฒนาซอฟต์แวร์ที่รองรับการทำงานร่วมกันระหว่าง CPU, GPU และตัวเร่งประมวลผลเฉพาะทาง
การประกาศดังกล่าวเกิดขึ้นภายในงาน Open Compute Project (OCP) Global Summit โดย Intel ให้ความสำคัญกับการลดต้นทุนการประมวลผล AI การใช้พลังงานอย่างมีประสิทธิภาพ และการสร้างระบบที่สามารถขยายขนาดได้ตามความต้องการขององค์กร โดยไม่จำเป็นต้องผูกติดกับฮาร์ดแวร์หรือซอฟต์แวร์เพียงแพลตฟอร์มเดียว
Intel GPU D-Series เน้น AI Inference พร้อมหน่วยความจำสูงสุด 480GB
หัวใจสำคัญของการประกาศครั้งนี้คือ Intel GPU D-Series ที่พัฒนาบนสถาปัตยกรรม Xe3P โดยออกแบบมาเพื่อรองรับงาน AI Inference ที่ต้องประมวลผลอย่างต่อเนื่อง ใช้หน่วยความจำปริมาณมาก และให้บริการคำขอจากผู้ใช้งานหลายรายพร้อมกัน
สเปกสำคัญที่ Intel เปิดเผยมีดังนี้
- สถาปัตยกรรม: Intel Xe3P
- หน่วยความจำ: LPDDR5X สูงสุด 480GB
- แบนด์วิดท์หน่วยความจำ: 1.5TB/s
- ประสิทธิภาพการประมวลผล: สูงสุด 1.3 PFLOPS สำหรับ FP8
- กำลังไฟ: 350 วัตต์
- การเชื่อมต่อ: PCIe
- ระบบระบายความร้อน: Air Cooling
จุดเด่นของ GPU รุ่นนี้ไม่ได้อยู่ที่พลังประมวลผลเพียงอย่างเดียว แต่เป็นการจัดสมดุลระหว่างความจุหน่วยความจำ แบนด์วิดท์ และการใช้พลังงาน เพื่อให้เหมาะกับงาน Inference ที่ต้องรองรับโมเดลขนาดใหญ่และการประมวลผลต่อเนื่องเป็นเวลานาน
หน่วยความจำ LPDDR5X ขนาดสูงสุด 480GB ยังเป็นองค์ประกอบสำคัญสำหรับการใช้งานโมเดลภาษาขนาดใหญ่ (LLM) โดยเฉพาะโมเดลที่มีจำนวนพารามิเตอร์สูงหรือมี Context Window ขนาดใหญ่ อย่างไรก็ตาม ความจุหน่วยความจำที่เพียงพอไม่ได้หมายความว่าจะทำให้ทุกโมเดลทำงานได้เต็มประสิทธิภาพโดยอัตโนมัติ เพราะยังขึ้นอยู่กับรูปแบบความแม่นยำของโมเดล ปริมาณ KV Cache ซอฟต์แวร์ และประสิทธิภาพการประมวลผลร่วมด้วย
รองรับโมเดล 300 พันล้านพารามิเตอร์ต่อการ์ด และมากกว่า 1 ล้านล้านพารามิเตอร์ในระบบ 8 GPU
Intel ระบุว่า GPU D-Series ได้รับการออกแบบให้รองรับโมเดลขนาดสูงสุด 300 พันล้านพารามิเตอร์บนการ์ดเดียว และโมเดลขนาดมากกว่า 1 ล้านล้านพารามิเตอร์ในระบบที่ใช้ GPU จำนวน 8 ตัว
ความสามารถดังกล่าวมุ่งตอบโจทย์ผู้ให้บริการ AI ที่ต้องการนำโมเดลขนาดใหญ่มาให้บริการแก่ผู้ใช้งานหลายรายพร้อมกัน รวมถึงงานหุ่นยนต์และแอปพลิเคชันที่ต้องการการตอบสนองรวดเร็ว
การเพิ่มความจุหน่วยความจำช่วยลดข้อจำกัดในการนำโมเดลขนาดใหญ่มาใช้งาน แต่ตัวเลขจำนวนพารามิเตอร์ที่รองรับไม่ใช่ตัวชี้วัดความเร็วโดยตรง ประสิทธิภาพจริงยังต้องพิจารณาร่วมกับปริมาณข้อมูลที่ประมวลผลต่อวินาที (Throughput) เวลาในการตอบสนอง (Latency) และจำนวนคำขอที่ระบบสามารถจัดการได้พร้อมกัน
Intel ยังระบุว่า GPU รุ่นนี้ใช้รูปแบบการ์ด PCIe มาตรฐานและระบบระบายความร้อนด้วยอากาศ เพื่อช่วยให้ติดตั้งในโครงสร้างพื้นฐานดาต้าเซ็นเตอร์เดิมได้ง่ายขึ้น โดยไม่จำเป็นต้องออกแบบระบบระบายความร้อนเฉพาะทางสำหรับตัว GPU
ปัจจุบัน Intel ระบุว่าเริ่มดำเนินการส่งตัวอย่าง GPU D-Series ให้ลูกค้าทดสอบแล้ว และกำลังขยายความร่วมมือกับผู้ผลิตเซิร์ฟเวอร์ ผู้ให้บริการคลาวด์ และบริษัทซอฟต์แวร์ เพื่อเตรียมแพลตฟอร์มสำหรับการใช้งานจริง
Intel Xeon ยังคงเป็นหัวใจสำคัญของระบบ Agentic AI
อีกหนึ่งประเด็นที่ Intel ให้ความสำคัญคือบทบาทของ CPU ในระบบ Agentic AI ซึ่งแตกต่างจากการใช้งาน AI ที่เน้นการสร้างข้อความหรือภาพเพียงขั้นตอนเดียว
Agentic AI สามารถทำงานต่อเนื่องหลายขั้นตอน ตั้งแต่การค้นคืนข้อมูล การวางแผนและให้เหตุผล การเรียกใช้เครื่องมือ การประสานงานระหว่าง Agent ไปจนถึงการดำเนินการตามคำสั่ง งานเหล่านี้ต้องอาศัยทั้งการประมวลผลทั่วไป การจัดการข้อมูล และการควบคุมการทำงานของตัวเร่งประมวลผล
Intel จึงนำเสนอระบบเซิร์ฟเวอร์ที่ใช้ Intel Xeon ร่วมกับ GPU และตัวเร่งประมวลผลเฉพาะทาง เพื่อให้แต่ละส่วนรับผิดชอบงานที่เหมาะสมกับความสามารถของตนเอง
บริษัทเปิดเผยว่า Xeon 6+ บางรูปแบบการจัดวางสามารถขยายจำนวนคอร์รวมได้มากกว่า 46,000 คอร์ต่อแร็ก โดยมีการใช้พลังงานรวมของแร็ก 133.45 กิโลวัตต์ ตัวเลขนี้เป็นข้อมูลของการจัดวางระบบบางรูปแบบ ไม่ใช่ข้อกำหนดของเซิร์ฟเวอร์ Xeon ทุกระบบ
Intel ยังนำเสนอการออกแบบแร็กที่พัฒนาร่วมกับพันธมิตร โดยหลายระบบอ้างอิงมาตรฐาน Open Rack v3 (ORv3) ของ Open Compute Project เพื่อช่วยให้การติดตั้งและการเชื่อมต่อกับโครงสร้างพื้นฐานดาต้าเซ็นเตอร์ทำได้ง่ายขึ้น
แนวคิดสำคัญคือการใช้ CPU จัดการงานทั่วไป การเคลื่อนย้ายข้อมูล และการประสานงานระหว่าง Agent ขณะที่ GPU รับภาระการประมวลผล AI ที่เหมาะสมกับสถาปัตยกรรมของตน วิธีนี้ช่วยให้การประเมินประสิทธิภาพระบบ AI ต้องมองไกลกว่าความเร็วของ GPU เพียงตัวเดียว แต่ต้องพิจารณาด้วยว่าระบบสามารถรองรับ Agent ที่ทำงานพร้อมกันได้กี่ตัว ภายใต้ข้อกำหนดด้าน Latency และพลังงานที่กำหนดไว้
ซอฟต์แวร์เปิดและการรองรับโมเดลใหม่เป็นปัจจัยสำคัญ
Intel ระบุว่าการสร้างระบบ AI ที่ประกอบด้วยฮาร์ดแวร์หลายประเภทจำเป็นต้องมีซอฟต์แวร์ที่เชื่อมโยงองค์ประกอบต่าง ๆ เข้าด้วยกันได้ โดยบริษัทมุ่งเน้นการผสานรวมเข้ากับ AI Framework, Inference Runtime และเครื่องมือพัฒนาที่ใช้งานกันอยู่แล้วในอุตสาหกรรม
แนวทางดังกล่าวประกอบด้วยประเด็นสำคัญ ได้แก่
1. ใช้ซอฟต์แวร์พื้นฐานร่วมกันระหว่าง GPU ของ Intel
GPU D-Series ใช้พื้นฐานซอฟต์แวร์ตระกูล Xe ร่วมกับแพลตฟอร์ม GPU ของ Intel เพื่อช่วยให้การนำแอปพลิเคชันไปใช้งานบนฮาร์ดแวร์ต่างรุ่นทำได้ง่ายขึ้น ลดภาระในการปรับซอฟต์แวร์ใหม่สำหรับแต่ละแพลตฟอร์ม
2. สนับสนุน AI Framework และเครื่องมือประสิทธิภาพ
Intel มุ่งทำงานร่วมกับ Framework และ Serving Engine ที่นักพัฒนาใช้งานอยู่แล้ว พร้อมใช้ไลบรารีและซอฟต์แวร์สำหรับปรับแต่งประสิทธิภาพ เพื่อเพิ่ม Throughput ของงาน Inference ทั้งบน CPU Xeon และ GPU ของบริษัท
3. รองรับโมเดล Open Model รุ่นใหม่ตั้งแต่ช่วงแรก
Intel ระบุถึงความพยายามในการรองรับโมเดลเปิดรุ่นใหม่ผ่านการผสานรวมเข้ากับ Framework โดยยกตัวอย่าง Meta Muse Glimmer ซึ่งได้รับการรองรับในลักษณะ Day 0 Support เพื่อให้นักพัฒนาสามารถเริ่มประเมินและนำโมเดลไปทดลองใช้งานได้เร็วขึ้น
4. รองรับการสร้าง AI Agent สำหรับองค์กร
Intel AI for Enterprise Agent Toolkit เป็นอีกส่วนหนึ่งของระบบนิเวศ โดย Intel ระบุว่า Toolkit ดังกล่าวได้รับการปรับแต่งและสามารถนำไปใช้งานบน Xeon ได้แล้ว พร้อมออกแบบสถาปัตยกรรมให้สามารถขยายการรองรับไปยัง GPU ของ Intel เพื่อรองรับ Workflow ที่มีความซับซ้อนและการทำงานแบบ Multimodal
ทั้งนี้ การมีซอฟต์แวร์พื้นฐานร่วมกันไม่ได้หมายความว่าแอปพลิเคชันทุกตัวจะสามารถทำงานข้ามฮาร์ดแวร์ได้ทันทีโดยไม่ต้องปรับแต่ง ความเข้ากันได้ยังขึ้นอยู่กับ Framework, Runtime, Driver และการรองรับโมเดลแต่ละรุ่น
ผลักดันมาตรฐานเปิดเพื่อลดข้อจำกัดในการขยายระบบ
นอกเหนือจากฮาร์ดแวร์และซอฟต์แวร์ Intel ยังเดินหน้าร่วมพัฒนามาตรฐานโครงสร้างพื้นฐานแบบเปิดผ่าน Open Compute Project โดยบริษัทระบุว่ามีส่วนร่วมในโครงการดังกล่าวรวม 116 ครั้งนับตั้งแต่ปี 2011
ภายในงานครั้งนี้ Intel ยังนำเสนอผลงานร่วมกับพันธมิตรใน Open Adapter Card Workgroup ซึ่งมีเป้าหมายในการกำหนดรูปแบบการ์ดเร่งประมวลผลมาตรฐานสำหรับติดตั้งในระดับ Sub-rack เพื่อเพิ่มความเข้ากันได้ทั้งด้านกลไก การเชื่อมต่อทางไฟฟ้า และการจัดการระบบ
หากมาตรฐานเหล่านี้ได้รับการนำไปใช้อย่างแพร่หลาย ผู้ผลิตเซิร์ฟเวอร์และผู้ให้บริการคลาวด์จะมีทางเลือกในการออกแบบระบบมากขึ้น และสามารถปรับเปลี่ยนฮาร์ดแวร์ตามความต้องการของงาน AI โดยไม่จำเป็นต้องออกแบบโครงสร้างพื้นฐานใหม่ทั้งหมดทุกครั้ง
บทสรุป: Intel ต้องการแข่งขันด้วยระบบ AI ทั้งแพลตฟอร์ม
Intel ต้องการวางตำแหน่งตัวเองในตลาด AI Infrastructure ด้วยการทำงานร่วมกันของ CPU, GPU, ซอฟต์แวร์ และมาตรฐานเปิด มากกว่าการแข่งขันด้วยตัวเลขประสิทธิภาพของชิปเพียงอย่างเดียว
GPU D-Series มีจุดเด่นที่หน่วยความจำสูงสุด 480GB แบนด์วิดท์ 1.5TB/s และกำลังไฟ 350 วัตต์ ซึ่งออกแบบมาเพื่อรองรับงาน Inference ที่ต้องใช้หน่วยความจำมากและให้บริการต่อเนื่อง ขณะที่ Xeon รับหน้าที่ประมวลผลทั่วไปและประสานงานระหว่างองค์ประกอบต่าง ๆ ของระบบ
อย่างไรก็ตาม ข้อมูลที่ Intel เปิดเผยในครั้งนี้ยังเน้นไปที่รายละเอียดทางเทคนิคและแนวทางการพัฒนาแพลตฟอร์มเป็นหลัก การประเมินว่า GPU D-Series จะมีความคุ้มค่าหรือแข่งขันกับโซลูชันจากผู้ผลิตรายอื่นได้มากน้อยเพียงใด จำเป็นต้องรอผลทดสอบประสิทธิภาพจริง ราคา และข้อมูลการใช้งานจากลูกค้าเพิ่มเติม
สำหรับตลาด AI ในระยะต่อไป ประเด็นที่น่าติดตามจึงไม่ใช่เพียงว่า GPU รุ่นใดมีพลังประมวลผลสูงที่สุด แต่รวมถึงความสามารถในการรองรับโมเดลขนาดใหญ่ การจัดการหน่วยความจำ การใช้พลังงาน และต้นทุนต่อการให้บริการ AI ที่มีประสิทธิภาพในระดับระบบโดยรวมด้วย
แหล่งข้อมูล: Intel Accelerates Open Infrastructure for the Agentic AI Era